自下而上的 AI 落地
从员工 idea 到生产的通道
品类经理的一句话
我们在一家消费品公司组织的第一场 Hackathon 里,一位工作了 8 年的品类经理拼出了一个"经销商月度报告自动生成"的 Agent。产出粗糙——UI 是 Streamlit 拉起来的,数据从 Excel 里导出的,Prompt 写得像口语。
但她的原话让整个团队安静了几秒钟:
"这个报告我每个月手工做 4 天,做了 5 年了,我一直以为公司没有人在乎。"
这句话价值几何,取决于接下来 6 周会发生什么。
如果这场 Hackathon 后面接的是一份 PPT + 一次全公司邮件表扬 + 三个月后没有任何后续——那这句话只值一份感动。反过来,如果这场 Hackathon 后面接的是一个 6 周 sprint 的资源池、一个明确的"上线负责人"、一套上线后的运营机制——那这句话就值一个正在生产里跑的 Agent,每个月省下 4 天,一年下来解放 48 天。
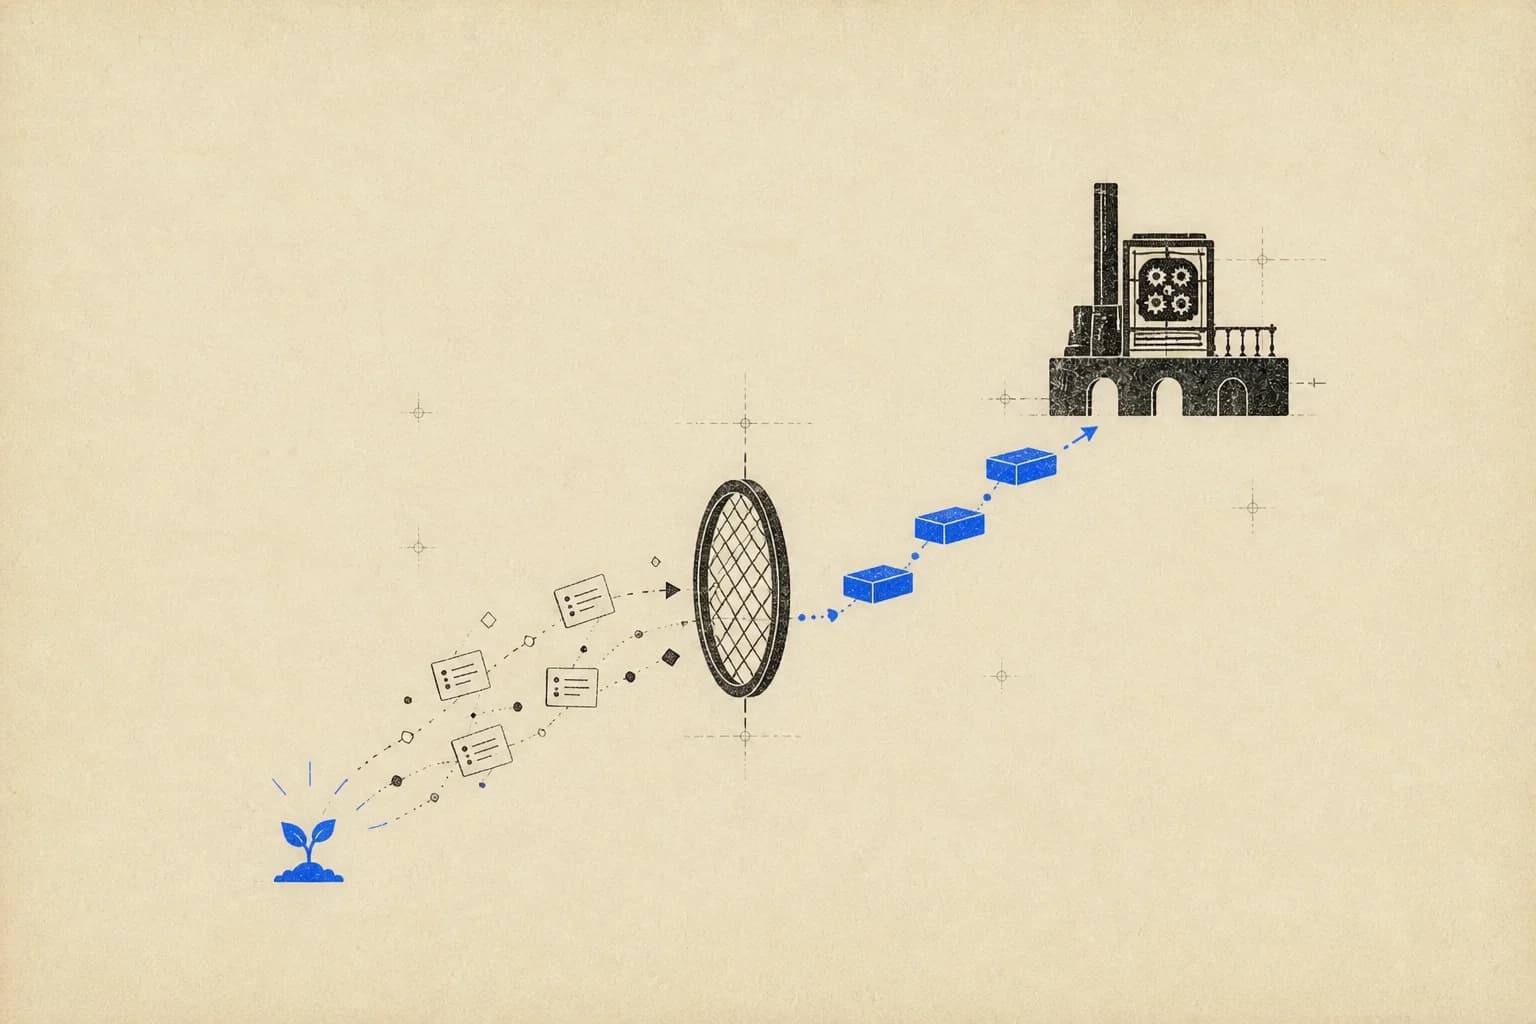
Bottom-up 路径的核心不是"办 Hackathon",是把员工的 idea 变成生产环境里天天在跑的东西。这篇讲怎么把这条通道建对。
先厘清:什么是自下而上
企业 AI 落地有两条路径。自上而下从企业级基建往下走:先建算力、数据、模型平台,再让业务方接入。自下而上从员工个人的第一个 Agent 往上走:先跑通场景,再抽象成平台。这篇专注在后者。想看两条路径的整体框架、什么时候偏哪一边、怎么让两条路径互相喂养,读 《企业 AI 落地的两条路径》。想看自上而下的深挖,读 《自上而下的 AI 基建:5 个支柱与最贵的失败》。
自下而上的核心哲学是先让业务跑起来,再从跑通的场景反推平台该建什么。它假设脱离真实业务的基建规划一定是猜的,猜出来的东西落地率极低。这个假设通常也是对的。这条路径适合迭代节奏快、组织相对扁平、试错文化容忍度高的企业。
个人层的四种舞台
自下而上路径的起点不是"发通知让员工用 AI"。是在员工面前搭一个可以自己上手的舞台。舞台的目的不是产 idea 本身,是让员工从"AI 是别人的事"变成"我能自己搞一个"。心态一转,后面的场景发现就会自然发生。这个"心态转变"是 Bottom-up 路径里最反直觉、也最重要的收益——不是一个技术产出,是一个组织能力的转变。
舞台通常有四种典型形态。
Hackathon 是最短平快的:一周内让员工围绕自己的业务问题拼一个能跑的 Agent。产出可能粗糙——UI 是 Streamlit 拉起来的,数据是从 Excel 导出的,Prompt 写得像口语。但暴露的痛点极其真实。开篇那位品类经理的场景,就是这样冒出来的。
AI 培训与认证 处理的是"能力不匹配"的问题:让员工从"知道 AI 是什么"变成"能自己搭一个",通过课程 + 实战 + 认证三步走。这一层的关键不是知识灌输,是让员工产生"我能做"的信心。
内部 Playground 是低门槛实验环境。员工可以在里面私自试各种模型、各种 Prompt,不需要审批,不需要开权限。试出问题的东西再走正式流程。这个"先试再报"的机制大幅降低了创新的门槛:员工不需要为一个还没被证明的想法去申请预算和 IT 支持。
提案通道是一个让员工提交"我想用 AI 解决 X"的入口,通常是一个简单的表单或内部工单系统。提案的门槛越低,能冒出来的痛点越真实。要求员工写 5 页立项文档的公司,一个季度可能收到 3 个提案;只需要填 3 行的公司,一个季度可能收到 300 个。数量上的差异不是"重视程度"的差异,是在多少人心里"提案是可能的"。
这四种形态可以组合,也可以只做一两个。核心不是形态,是"让员工有地方表达"。没有出口的员工创意,只会变成饭桌上的抱怨。一家企业里到底有多少个未被表达的场景,你在没有搭好舞台之前是不知道的。
团队层用三条硬标准过筛
员工提上来的 idea 里,通常 60–70% 是"我想用 AI"的模糊愿望,20–30% 是能干但不值得干的边缘场景,剩下 10% 才是真正能跑通的。团队层的核心动作是过筛——用三条硬标准筛出那 10%。
第一条是痛点足够真实。不是"我想用 AI",是"我每天在这件事上花 2 小时"。具体到时间、频率、责任人的痛点,才值得投入 6 周去做。抽象的痛点大多不是真痛点,只有具体到分钟的痛点才有价值。举个对比。一个员工说"我想用 AI 帮我整理会议纪要"——这是抽象痛点,落地下来可能只是个 nice-to-have。同一件事换个说法:"我们部门每周开 3 个跨部门会议,每次会后有个人要花 1 小时整理纪要发出来,一年下来大概 150 小时"——这就是真痛点。因为它带着数字、带着人、带着可以对比的 baseline。
第二条是场景足够聚焦。能被一个 Agent 在 6 周内跑通的场景,比"要改造整个客服体系"这种宏大提案有价值得多。聚焦意味着可以在有限时间里做出可验证的东西。上线一个跑得动的窄场景,远比给出一个覆盖广但没跑通的方案有说服力。一个跑通了"退款自动核对"的 Agent,可以说服 CFO 再投更多资源;一个覆盖"整个客服体系"的 PPT,只能说服 CFO 停投。
第三条是数据能拿到。业务系统里已经存在的数据、能被合法读取的数据,才值得做。如果需要重建数据源,这个场景应该先推到 Data 团队而不是 AI 团队。这一条最容易被忽略,也是最多项目死在半路上的原因。很多员工的 idea 听起来很好,但一深挖发现"要读到这个数据,需要三个部门协调、需要合规审批、需要 IT 建新的接口"。这种场景不是不该做,是不该由 Agent 团队去做,因为它的瓶颈不在 AI,在数据。
过筛不是拒绝,是反馈。给员工一个明确的信号——"你的 idea 我们认真看过,这次先不做,是因为 X"。这个反馈机制本身,就是下一波提案质量的驱动:如果员工的第一批 idea 只有沉默的回复,第二批就没有了;如果每一份提案都有一个具体的评估结论,员工会自己学会怎么提出更好的问题。一家公司里的"AI 提案质量",通常在第 3 个季度会出现分水岭——没有反馈机制的公司越来越差,有反馈机制的公司越来越好。
企业层怎么沉淀
跑通的场景不是终点。每一个成功的 Bottom-up 场景,都是给企业层的一个信号:这是最靠谱的基建需求发现方式,远比 IT 自己 brainstorm 出来的靠谱。因为 Bottom-up 场景带着两样 IT 自己产不出来的东西——一线的真实约束(数据不干净、流程有例外、责任链模糊),和已经被验证过的解法(不是猜的,是真跑过的)。
信号有三种典型形态。反复被使用的 Prompt 模式说明这是一类可复用的抽象。把它沉淀成 Prompt Registry 里的标准模板,下一个团队直接用,不需要重新调优。比如"从非结构化文档里提取表格并保持列语义一致"这样的模式,在合同审核、发票核对、财报解析多个场景反复出现。第一次做用了 3 周,第二次团队拿来复用 3 天,第三次做成了模板,之后 3 小时。
反复被调用的数据源说明这是一类高频数据接口。把它抽象成企业级数据接入 API,让数据接入的边际成本降为零。反复被触发的动作说明这是一类核心业务动作。把它抽象成 Ontology 里的 Action Type,让 Agent 通过统一的动作接口和权限模型来操作,而不是每个场景各自写调用逻辑。
这就是 Bottom-up 真正的价值——它是 Top-down 基建的需求发现机器。没有 Bottom-up 喂出来的场景,基建团队只能靠猜。任何一个 CIO 都会告诉你:猜出来的基建,落地率通常在 30% 以下。反过来说,从跑通的场景反推的基建,落地率通常在 80% 以上。因为那些能力本来就是被真实使用过的。这条基建怎么设计、5 个支柱是什么,见 《自上而下的 AI 基建:5 个支柱与最贵的失败》。
独特优势
从员工出发的路径有一组独特的优势:跑得比任何自上而下路线都快,而且贴地气。
速度是最直观的一项。一个 Hackathon 3 天出雏形,一个员工 idea 到 MVP 通常 6 周内完成,快的场景 2 周就能跑起来。对于业务方来说,这个节奏和"12 个月建平台"完全不是一个感受。从"我提了一个想法"到"这个想法在生产里跑起来了",如果间隔是 6 周而不是 12 个月,员工会真的相信这家公司在做 AI。这个信念本身就是巨大的资产。
痛点的真实度同样关键。一线员工每天在跟真实数据、真实流程、真实异常打交道,他们提出的场景背后是每天几十次的重复动作。这个真实度是任何战略咨询都产不出来的。咨询顾问跟员工聊 3 天,能识别出的痛点数量和精度,远远比不上员工自己每天在做这件事时的第一手感受。而且咨询顾问识别的痛点通常是"你说给外部听时会强调的",员工提案里的痛点是"你自己每天在骂但不好意思跟老板说的"。后者往往才是真正值得解决的。
员工参与感是一个容易被低估的红利。AI 不再是"IT 给的东西",是"我自己搭的东西",采纳率会因此显著提升——员工不会抵制自己参与设计的工具。这一点对企业来说是双重收益:既提升了 AI 项目的成功率,也提升了整个组织对"AI 未来会怎么改变工作"的接受度。因为员工看到的不是"AI 要取代我",是"AI 是我用来放大自己能力的工具"。
还有试错成本低。跑不通就下线,没有 sunk cost 也没有政治压力,团队可以快速切下一个 idea。相比 Top-down 那种一次性投几千万的模式,Bottom-up 的每个场景通常只是"投几个人 6 周",即使全部失败,损失也可控。
这些优点都建立在一个前提上:员工提出的 idea 真的被资源化、被跑通、被上线。没有这个反馈闭环,再多 idea 都只是给公司增加乐观情绪。年底一算账:Hackathon 办了 3 场、员工提交 200 个 idea、上线 0 个。这不是路径问题,是机制问题。看似办得热火朝天的 Bottom-up 活动,如果没有配套的资源化通道,最后只是给员工制造挫败感。
隐性代价
自下而上的代价更隐蔽:短期看不到,中长期一起浮出水面。
碎片化是最直接的。10 个部门自己跑 10 个 Agent,最后是 10 套 Prompt、10 套评估集、10 套接入方式、10 种不同的错误处理逻辑;跨部门的复用几乎为零。想让客服团队的 Agent 复用风控团队的评估集?往往需要从头再做一遍,因为两边的接口定义、数据格式、错误码规范都不一样。这种碎片化在最开始半年感觉不到——每个团队都在跑自己的场景,各自都跑得不错。但到了第二年,当你想把客服团队跑通的做法复制到销售团队时,就会发现**"复制"这件事本身比"从零做"还贵**——因为原来的东西没考虑过被复用。
难扩展紧随其后。单个场景跑得再好,跨场景复制却出奇地难。因为每个场景当初都是为特定业务、特定数据、特定权限设计的,抽象层缺失。一个团队做出的"完美 Agent",往往只在那一个团队的上下文里完美——搬到隔壁团队立刻各种不适配。
技术债累积快是致命的。员工自己拼的东西往往没考虑权限、审计、日志、监控。一开始跑得挺好,跑到第 3 个月开始出问题(Prompt 突然表现变差、模型响应时间飙升),跑到第 6 个月成为烫手山芋——想弃又不敢弃,因为业务方已经在用。这种"半瘫痪但停不了"的状态,是 Bottom-up 项目最典型的中晚期症状。
合规隐患是最后一颗雷。员工可能在不该访问的数据上用 LLM,可能把敏感信息塞进公有云模型,可能触发数据出境。这些踩线动作往往在很久之后才被发现,而发现的时候已经无法挽回。一家公司曾经因为一个员工在个人 Playground 里把客户完整名单送进公有云做分类,导致合规部门介入、整个 AI 部门被冻结审查 3 个月。这不是员工恶意,是没有基建的约束,个人层的自由必然带来违规。
这些代价不是 Bottom-up 本身错了,是 Bottom-up 单独跑必然的结局。想要享受它的快,就必须同步准备 Top-down 的收敛机制——这就是系列主篇里讲的"互相喂养"。
什么样的企业适合优先走这条路
互联网、消费品、创意服务、新经济:迭代节奏快、业务多样、组织结构相对扁平、试错文化强。前线员工对业务的理解深度往往超过管理层——从员工里冒 idea 是最快的场景发现方式。这些行业也普遍容忍"边跑边改",不需要在第一天就想清楚三年后的架构长什么样。而且这些行业的合规压力相对可控。一个消费品公司的员工在 Playground 里试新 Prompt,最坏的情况是浪费了两天时间,不会踩到数据出境或行业监管的红线。
真实案例:某消费品集团 2024 年办了 3 场"AI Ideathon",员工提交 200+ idea,团队筛出 12 个进入 6 周 sprint,最后 5 个上线。上线后的 3 个月里,这 5 个场景反过来定义了集团 AI 中台第一版的核心能力集——中台不是先建再用的,是先用再建的。这家集团现在的做法是"先跑场景、6 个月复盘、决定哪些能力值得沉淀",而不是"先想清楚中台架构、再让业务方来接"。他们的 CIO 有一句话我们记得很清楚:"我不知道我们的中台长什么样,但我知道跑完 20 个场景之后我会知道。"这是很聪明的一句话——它承认了自己在信息不足时不做决策,同时给了组织一个明确的信号:先跑起来。
反过来,如果你在银行、政府、能源这些强合规行业,先做 Bottom-up 往往会撞墙——员工没有开发环境,Playground 跑不起来,合规审批一层不通就废。这时候顺序应该反过来,先建标准化基建,让业务方合法开始。这条路径的深挖见 《自上而下的 AI 基建:5 个支柱与最贵的失败》。
Enduring principle: Bottom-up 不是"民主投票",是"场景发现"。让员工提案的目的不是让每个 idea 都上线,是让最真实的痛点浮出水面。
系列的另一半
自下而上负责找到该做什么,自上而下负责让能做的事变便宜。绝大多数企业的正解是让两者互相喂养——一线跑通的场景反哺基建,基建反过来加速一线的下一波场景。这个反馈机制怎么设计、翻译层是谁、给企业的 4 条实操建议是什么,读 《企业 AI 落地的两条路径》 系列主篇。