自上而下的 AI 基建
5 个支柱与最贵的失败
一份 40 页的架构文档
某集团 CIO 打开一份"企业级 AI 中台架构文档"。40 页。15 个能力模块。UML 图看起来很专业。业务方看完,问了一句:"这里面哪个模块能解决我们退款自动核对的问题?"
答不上来。
这不是个别现象。我们在客户现场反复看到的规律是:天然从架构图出发的 AI 中台项目,落地率通常在 30% 以下。反过来,从业务场景反推出来的 AI 中台,落地率能到 80%。两者的区别,往往就在一件事上——你有没有搞清楚企业级 AI 基建到底该是什么。
这篇专注在自上而下这条路径:从企业层建基建、往团队和个人层下发能力的做法。我们要拆的是五个支柱、三层收益、三个绕不过去的问题,以及什么样的企业该优先走这条路。
先厘清:什么是自上而下
企业 AI 落地有两条路径。自上而下从企业级基建往下走:先建算力、数据、模型平台,再让团队和个人接入。自下而上从员工个人的第一个 Agent 往上走:先跑通场景,再把有价值的部分抽象回填到平台。想看两条路径的整体框架、什么时候偏哪一边、怎么让两条路径互相喂养,读 《企业 AI 落地的两条路径》。想看自下而上的深挖,读 《自下而上的 AI 落地:从员工 idea 到生产的通道》。
自上而下的核心哲学是先把地基打好,让上面的人使用。它假设——通常也是正确地假设——底座建不好,上面的一切都是空中楼阁。这条路径适合有明确技术栈规划、能承受长期投入、组织自上而下有强执行力的企业。
五个支柱
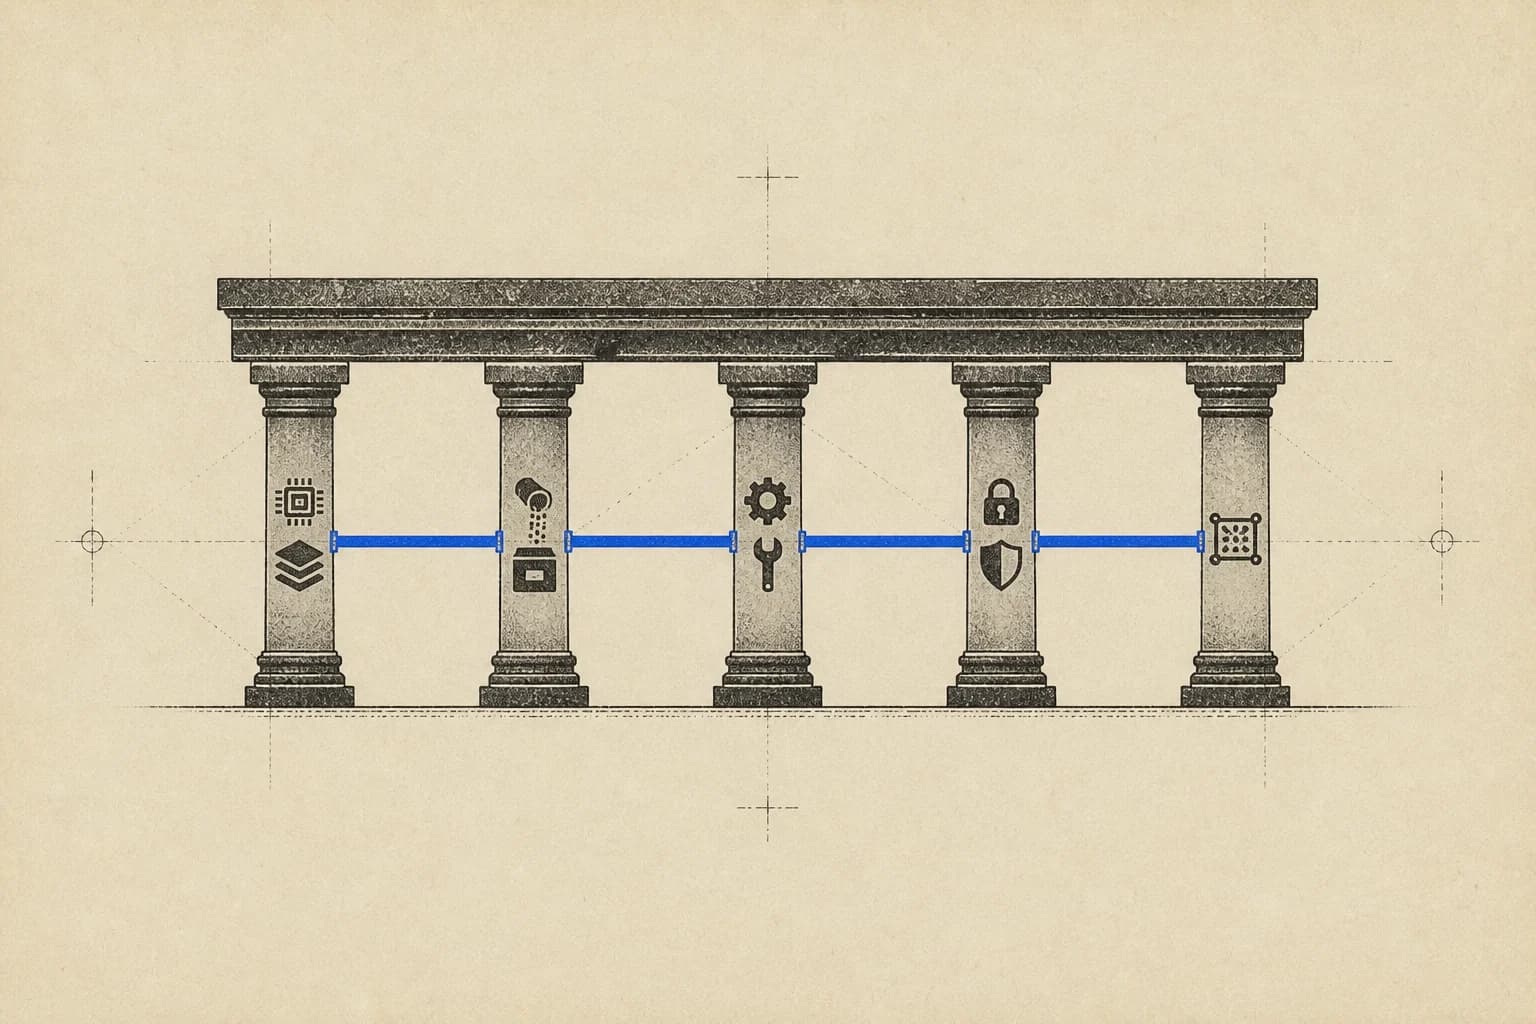
自上而下路径的核心动作,是在企业层建一套统一的 AI 基建。这件事看起来庞杂——涉及算力、数据、工具、权限、合规五个大类——但本质上是同一件事的五个面:把 AI 从"每个团队各自摸索"变成"可被统一调度的能力"。五面缺一不可。缺任何一面,另外四面的价值都要打折。
五个支柱一览:
| 支柱 | 解决什么问题 | 缺了会怎样 |
|---|---|---|
| 算力与模型平台 | "用哪个模型"变成 API 参数 | 每个团队自己谈接入方式、部署、切换,占 40% 时间 |
| 知识库与数据接入层 | 让 Agent 读到被治理过的数据 | 12 个团队实现 12 套向量库,同一客户信息长得都不一样 |
| 通用能力平台 | 集中 Agent 工具(Runtime、Registry、Eval、灰度) | 60% 工时花在重复造轮子,只有 40% 花在业务逻辑 |
| 权限与治理 | 对象层的安全模型,Agent 敢接生产 | 应用层重复实现,极易出错 |
| 合规护栏 | 强监管行业的第一道门 | 上线两周被合规叫停 |
下面把每一支柱展开一层。
算力与模型平台是第一件事。把 GPU 资源统一到一个可调度的池子里,同时在上面搭一层模型接入抽象。开源模型、商业模型、自研模型都能通过同一套 API 被业务方调用,成本按团队和场景自动归集。它的价值在于让"用哪个模型"变成一个 API 参数,而不是一个采购决策。没有这一层,每个团队都要自己去谈 OpenAI 合同、自己去部署开源模型、自己去处理供应商切换。一个大型企业十几个 AI 场景跑下来,光是模型采购和运维就能占掉团队 40% 的时间。
企业知识库与数据接入层处理的是"数据能被 Agent 用"这件事。跨部门数据的统一接入、脱敏、向量化、检索,都收敛到一个抽象层背后。业务方不用关心底层是 Snowflake 还是 Oracle,也不用为每个新场景重新写数据管道。Agent 通过一个统一的接口就能访问所有被授权的数据。这一层最大的价值不是"让 Agent 能读到数据"(这个每个团队自己也能实现),而是让 Agent 读到的数据是被治理过的:去重过、脱敏过、有权限约束的。没有这一层,你会看到 12 个团队各自实现 12 套向量库,同一个客户的信息在 12 个索引里长得都不一样。
通用能力平台是把 Agent 相关的工具集中化:Agent Runtime、Prompt Registry、评估集平台、灰度与回滚工具。这些能力每个场景都要用,如果不集中,每个团队都在重复造轮子。我们在一家客户现场统计过:他们十个 AI 场景的开发时间,60% 花在这类通用工具上(Prompt 管理、评估、A/B 测试、错误监控),只有 40% 花在真正的业务逻辑上。有了统一的通用能力平台之后,这个比例应该反过来。
权限与治理回答的是"谁能用什么"。模型访问权限、数据可见性、动作留痕、审计路径,都加在对象层面,而不是加在应用层面。这一层做不好,Agent 敢真正接入生产的门槛就出不来;做得好,之后每一个新场景都能免费继承整套安全模型。举个具体的例子。如果权限模型是加在对象层的,那"华南销售 Alice 能看到自己名下客户,看不到华北客户"这条规则,写一次,全公司所有 Agent 都自动遵守。如果加在应用层,每个 Agent 都要自己实现一遍:不仅重复劳动,还极容易出错。
合规护栏在金融、医疗、政府等强监管行业里尤其关键。数据出境、隐私、行业监管,任何一条踩红线都会让 AI 项目直接停摆。这不是可以事后打补丁的层,是从第一天就必须存在的边界。一家金融客户曾经在生产环境部署了一个客服 Agent,试运行两周就被合规部门叫停。原因是 Agent 在处理客户咨询时,把客户姓名和身份证号明文送进了公有云模型。这个坑不是技术问题,是从设计第一天就没有合规约束导致的。
这五块不需要一次性建齐,但每一块都必须有明确的 owner 和验收指标。没有 owner 的基建,最终都会变成 shelfware:存在于架构图里,不存在于业务方的日常里。
团队和个人层怎么接入
企业层把底座建好之后,团队和个人层的角色就变成了"消费者"。分工很清楚,动作也很轻。这个"轻"是自上而下路径最大的红利之一:当底座扎实,上层的边际成本可以极低。
团队层做的是场景适配:拿到"能力包"接到具体业务上。风控团队接反欺诈场景、客服团队接自动核对场景、采购团队接合同审核场景,每个团队只需要往上贴场景专属的 Prompt、评估集和业务规则,不需要重新搭底座。这一层的产出物是"跑通的场景":数据接进来、规则跑起来、结果被业务方验收。团队层需要的能力更接近"业务分析师 + 应用工程师",不是"AI 研究员"。一个成熟的团队,从拿到能力包到跑通一个新场景,通常需要 2–4 周。如果拿到的是一个完整的 SDK 而不是一堆散接口,甚至可以压到 1 周。
个人层做的是使用和熟练。员工不需要理解底层的模型或数据流,只需要会用 Prompt Registry 里的模板、会在内部 Agent Playground 里试跑、会用 Agent 处理自己每天的工单。这层看起来最轻,但它决定了整个平台的采纳率。一线员工不用,前两层建得再好也是自嗨。个人层最容易被低估。企业投了几千万建了一套漂亮的平台,然后发现员工还在用微信搜索代替系统检索——这样的故事在中国企业里每天都在发生。采纳率的天花板永远由用户体验决定,而不是由底层技术决定。
两层的关键都是"不重复造轮子"。如果每个团队都要从零搭一套 Prompt Registry,那企业层的基建就白建了;如果每个员工都在自己电脑里跑一套私有的 GPT 脚本,那治理层就形同虚设。基建的价值不在建,在强制统一。它的合理性只能通过下游被反复复用才成立。反过来说:如果基建建了半年之后,团队和个人还在绕开它跑自己的东西,那基建的方向大概率错了。
三层收益
自上而下的收益不在建成的那一刻,在之后每一个新场景接入的时候。前期的重投入会在几十个场景之后被摊平。这个"摊平"的过程本身,就是这条路径最值得等的东西。要理解这个红利,你需要看的是十个场景之后的边际成本,而不是第一个场景的绝对成本。
其中一项是规模化基础。1 套基建服 100 个场景,边际成本随场景数量递减。第 100 个场景的接入成本,通常远远低于第 10 个;到了这个阶段,业务方接一个新场景就像点一个按钮,不再是一次项目。一家我们服务的银行做过内部测算:他们的第 1 个 AI 场景(客服 FAQ)从立项到上线用了 8 个月,第 20 个场景(信贷预审)从立项到上线只用了 6 周。基建把每个场景的启动成本压到了几乎为零。
另一项是合规风控统一。审计、追责、回滚共用一条链,不需要每个场景各自实现权限模型和留痕日志,也不会因为某个场景漏了合规环节而拖累整个平台。对于强监管行业来说,这不是"锦上添花",是能不能上线的分水岭。在我们接触过的金融和医疗项目里,合规审查通常是上线前最大的瓶颈。如果每个 Agent 都要走一遍完整的合规评审,一年也上不了几个;如果整个平台已经通过了合规基线,单个场景的评审可以缩到 2 周。
最容易被低估的是跨场景复用。一个部门做出的评估集或 Prompt 模板,别的部门直接用,不用重新验证。一年下来,光是这一项就能省掉 30% 的开发时间。一个 Prompt 模板在客服团队被验证过一次,风控团队复用时只需要针对自己的领域微调;一个评估集在合同审核场景被建立起来,未来所有涉及"文本结构化提取"的场景都可以从它开始。这种复用不是自动发生的,需要一个中心化的 Registry 来支撑。但只要机制建立起来,收益是复利式的。
这几项加起来是一个"平台效应":用得越多越便宜,接得越多越稳。前期的痛几乎是必然的,但只要撑过 20 个场景,ROI 曲线就会陡然上翘。真正走完这条路的企业往往在第 3 年会说:"如果 3 年前不建那个平台,我们今天不可能接得住业务的需求。"
三个绕不过去的问题
但这条路径的代价也很直白:三个绕不过去的问题,任何一个都可能让平台项目在中途死掉。
慢:一套企业级 AI 平台从立项到能被业务方真正用起来,通常需要 12–18 个月。这中间业务方看不到产出、管理层看不到 ROI,很容易在第 6–8 个月被砍。很多"AI 中台"项目死在第一年的第三季度,就是因为这个。这个时点非常典型:立项激情已经过去,第一波演示已经做完,但真正的能力还没有跑通任何业务;管理层开始追问"我们到底做出了什么",团队拿不出让人信服的答案,项目就在这个 gap 里熄火。
贵:前期投入包括算力采购、平台开发、治理咨询、合规审计,一次性铺开的成本通常是几百万到几千万人民币级别,取决于企业规模和行业属性。而且这些钱大部分要在看不到明确 ROI 的前提下投出去。CFO 通常需要一个"跳跃式的信任",才能签下这笔预算。很多企业的解法是先切一小块("先做一个小型内部工具"),但小切块又拿不到规模化红利,反而进入了"投入小 → 看不到规模效应 → 觉得没用 → 停投"的死循环。
但最贵的其实是**"建好没人用"的风险**。IT 花 12 个月做出的平台,业务方用不起来,因为 IT 猜的场景和一线真实需要的场景根本对不上。这时候基建变成了博物馆:存在、可参观、但不生产任何东西。我们在客户现场见过太多次这种失败。一个漂亮的"AI 中台",UI 精致、文档完整、演示流畅,但打开日志一看,每天的调用次数是个位数——因为没有一个真实业务在用它。它比慢和贵加起来还伤。不仅钱和时间没了,团队对"AI 能不能落地"的信心也一起没了。下一次再提立项,管理层的第一反应会是"我们上次那个不是也没成吗"。
什么样的企业适合优先走这条路
重资产、强合规、大型组织:银行、保险、电力、电信、政府、大型制造。这些行业里,个人和团队层的自主试错空间本就有限。合规和权限是第一道硬门槛:员工没有开发环境,甚至没有互联网访问权限,Bottom-up 从物理上就跑不起来。让员工"自己搭一个 Agent 试试"在这些环境里根本没法开始。数据在内网、模型在私有云、每一次调用都要审计。先建标准化基建反而是最快的路径——它是唯一能让业务方合法开始的路径。
一个真实的例子。某国有大行 2023 年上马"AI 中台"项目,18 个月内建成统一的算力、模型接入、评估集平台。这 18 个月里,业务方几乎没有产出,只有几个内部 PoC。管理层承受了不小的压力,好几次差点砍掉这个项目。但第 19 个月开始,各分行的 20+ AI 场景接入速度从"3 个月一个"变成"2 周一个"。到了第 24 个月,全年新增场景 45 个,覆盖了从零售信贷到反欺诈到合规审查的多个业务域。基建的收益不在建成的那一刻,在之后每一个接入场景省下的时间。这家银行现在每季度上线 5–6 个新场景,规模化效应开始显现。
反过来,如果你在互联网、消费品、创意服务这些迭代节奏快、组织扁平的行业,先做自上而下往往是错的——你会为一个没跑通任何场景的平台投入 12 个月,而竞争对手已经跑通了 5 个 Bottom-up 场景。这时候顺序应该反过来,先让员工产 idea、团队筛出 3–5 个跑起来,再从跑通的场景反推平台该建什么。这套做法的完整展开,见 《自下而上的 AI 落地:从员工 idea 到生产的通道》。
Enduring principle: Top-down 是杠杆,不是产品。它的价值在于让后续的每个场景都便宜、快、可信。
系列的另一半
自上而下的价值在长跑,自下而上的价值在起跑。绝大多数企业的正解不是二选一,是同时走——让 Bottom-up 找到的痛点变成 Top-down 的能力清单,让 Top-down 的基建变成 Bottom-up 的加速器。这两条路径怎么互相喂养、翻译层是什么、给企业的 4 条实操建议是什么,读 《企业 AI 落地的两条路径》 系列主篇。