企业 AI 落地的两条路径
为什么最好的答案是"同时走"
一个反复出现的会议室场景
CEO 在董事会拍了板:"今年公司要用起 AI。"
会议室里的角色瞬间开始站队。IT 部门说要先建一个统一的算力平台和知识库,不然后面全是数据孤岛;业务方说我们连能用 AI 做什么都还不清楚,先给一线试试再说;HR 说培训得跟上,法务说合规得先摸清,采购问预算给谁。每一方的立场都合理,每一方的诉求都写得进 PPT。但每一方都不能单独往前推动。半年过去,公司还在这场僵局里。立项文件改到第 12 版,第一行代码还没写。
我们在很多客户现场都见过这一幕。它的根源不是决心不够,也不是能力不够。是分层错位:不同的角色其实在讨论不同的问题,但大家都以为在讨论同一件事。IT 讨论的是"AI 能力怎么被稳定供给",业务方讨论的是"我明天要做的这件事能不能被 AI 替代",HR 讨论的是"员工怎么跟上",法务讨论的是"哪些数据不能出边界"。每一个都是 AI 落地里真实的问题,但它们的答案不在同一个决策桌上。
企业 AI 落地不是一个方向的问题,是两条路径的问题:一条从企业级基建往下走(top-down),一条从员工个人的第一个 Agent 往上走(bottom-up)。绝大多数企业犯的错,是只走一条。这篇文章要讲的,是这两条路径各自解决什么问题、什么样的企业该偏哪一边,以及为什么最好的答案是同时走。
三层视角,两条路径
企业里跟 AI 有关的组织结构,拆到最粗的力度就三层。
企业层是 CIO、CDO、数字化委员会做的事,管的是基础设施、跨部门治理、预算和合规。这一层的决策一次影响全公司:我们用不用私有化部署,模型的采购和评估怎么统一。团队层是业务部门、事业部、产品线做的事,负责把能力接到自己的场景里。这一层的决策影响一条产线或一个业务单元:客服团队用 Agent 处理退款该怎么设计,风控团队的 Agent 什么情况下能自动拒单。个人层是员工做的事,用工具解决自己每天遇到的问题。这一层的决策粒度最小,可能只是"今天这封复杂邮件我用 Claude 起个草稿"。但正是无数这样的日常动作累积起来,决定了一家公司到底"用没用起 AI"。
这三层不是行政意义上的隶属关系,是决策粒度的不同。想清楚这三层,两条路径也就出来了。
自上而下走的是"企业 → 团队 → 个人"。先在企业层建基建(算力、模型接入、知识库、Agent Runtime、权限治理),团队层拿到"能力包"做行业适配,个人层学工具、用工具。这条路径的哲学是"先把地基打好,再让上面的人使用"。它假设底座建不好,上面的一切都是空中楼阁。这个假设通常也是对的。这条路径适合有明确技术栈规划、能承受长期投入、组织自上而下有强执行力的企业。
自下而上正相反:"个人 → 团队 → 企业"。从员工个人出发,通过 Hackathon、培训、内部 Playground 冒出一批 Agent idea;团队筛出 3–5 个高价值场景落地到生产;企业层再把这些跑通的场景抽象成可复用的能力,回填到基建。这条路径的哲学是"先让业务跑起来,再从跑通的场景反推平台该建什么"。它假设脱离真实业务的基建规划一定是猜的,猜出来的东西落地率极低。这个假设同样通常是对的。这条路径适合迭代节奏快、组织相对扁平、试错文化容忍度高的企业。
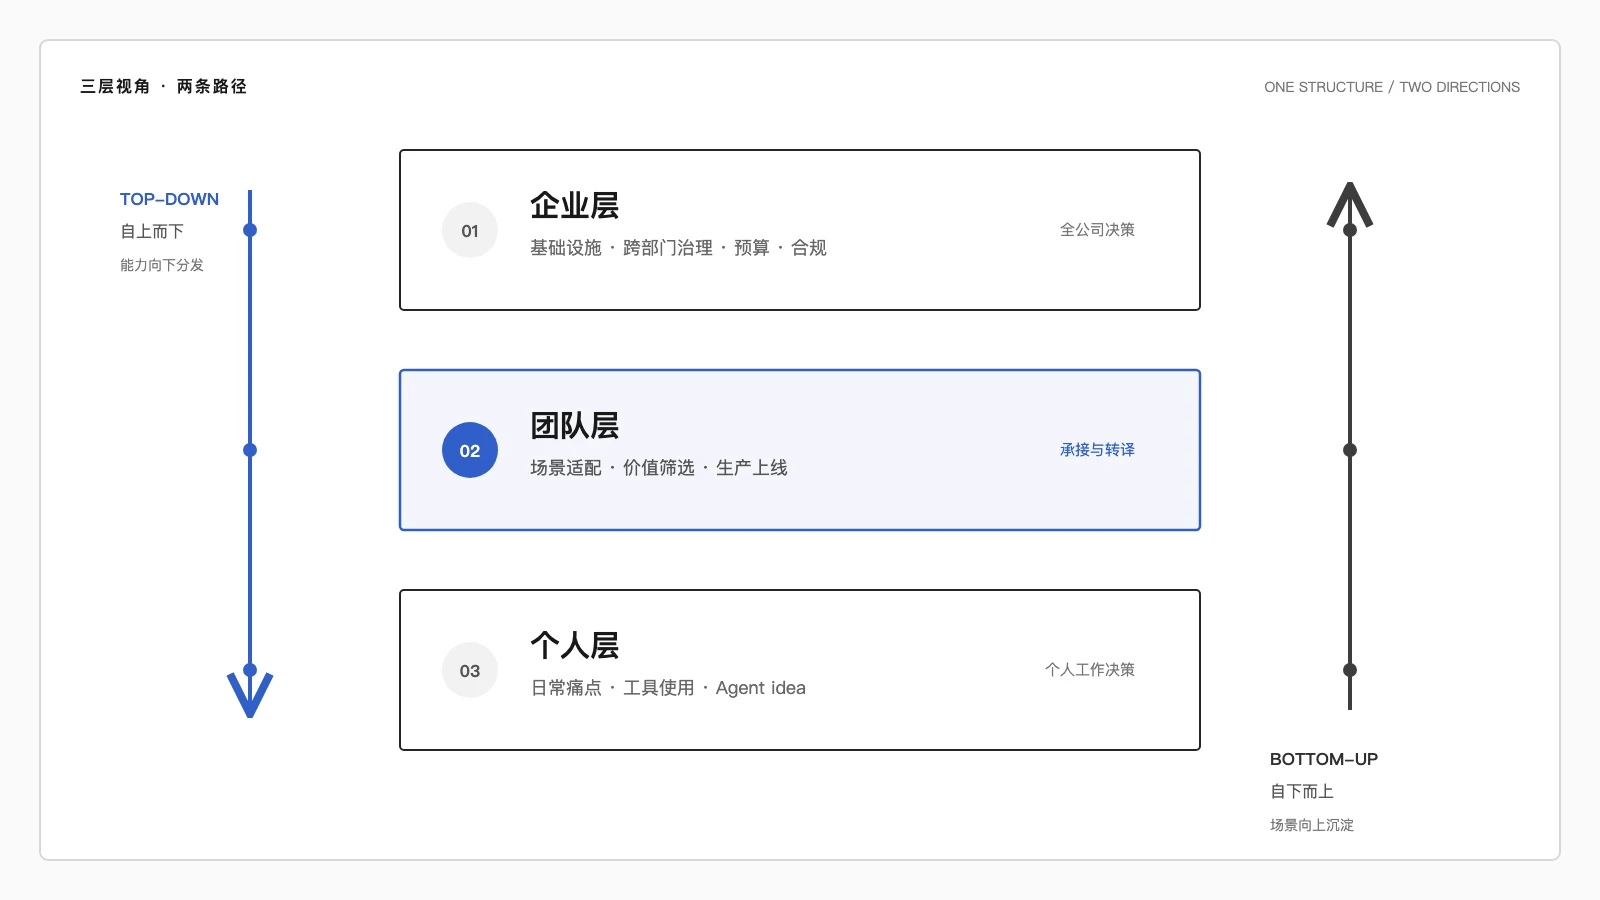
Enduring principle: Top-down 决定"能不能做",Bottom-up 决定"该做什么"。两条路径解决的根本不是同一个问题——选边站队的公司只解决了一半。
一眼对比两条路径:
| 自上而下(Top-down) | 自下而上(Bottom-up) | |
|---|---|---|
| 顺序 | 企业 → 团队 → 个人 | 个人 → 团队 → 企业 |
| 起点 | 建 AI 基建(算力、模型、数据、治理) | 员工 Hackathon / Playground / 提案 |
| 哲学 | 先把地基打好,让上面的人使用 | 先让业务跑起来,从场景反推平台 |
| 回答的问题 | "能不能做" | "该做什么" |
| 典型交付周期 | 12–18 个月见平台 | 3 天出雏形,6 周到 MVP |
| 主要收益 | 规模化、合规统一、跨场景复用 | 快、贴地气、员工参与感 |
| 主要风险 | "建好没人用" | 碎片化 + 技术债累积 |
| 适合企业 | 银行、电力、政府等重合规行业 | 消费品、互联网、创意服务 |
自上而下 · 先铺地基(要点速览)
自上而下路径的核心动作,是在企业层建一套统一的 AI 基建,把 AI 从"每个团队各自摸索"变成"可被统一调度的能力"。这套基建有 5 个绕不过的支柱:算力与模型平台、企业知识库与数据接入层、通用能力平台、权限与治理、合规护栏。缺任何一个,其他 4 个的价值都要打折。
这条路径的收益在于长期的平台效应:1 套基建服 100 个场景,边际成本随场景数量递减;合规风控共用一条链;跨部门可复用。一家我们服务的银行,第 1 个 AI 场景从立项到上线用了 8 个月,第 20 个场景只用了 6 周。代价同样明确:慢(12–18 个月才有可用平台)、贵(前期一次性投入几百万到几千万),以及最贵的一种失败——"建好没人用",因为 IT 猜的场景对不上业务方真实需要的。
适合走这条路的企业是重资产、强合规、大型组织:银行、保险、电力、政府、大型制造。这些行业里合规和权限是硬门槛,员工没有开发环境甚至没有互联网访问,先建标准化基建反而是最快的路径。
想看深挖——5 个支柱各自解决什么、三层收益怎么累积、三个绕不过去的问题怎么规避、某国有大行 18 个月建平台的完整案例——读 《自上而下的 AI 基建:5 个支柱与最贵的失败》。
Enduring principle: Top-down 是杠杆,不是产品。它的价值在于让后续的每个场景都便宜、快、可信。
自下而上 · 从个人 idea 起步(要点速览)
自下而上路径的核心不是"发通知让员工用 AI",是在员工面前搭一个可以自己上手的舞台——通常有 4 种典型形态:Hackathon、AI 培训与认证、内部 Playground、提案通道。舞台的目的不是产 idea 本身,是让员工从"AI 是别人的事"变成"我能自己搞一个"。
员工提上来的 idea 里,60–70% 是模糊愿望,20–30% 是不值得干的边缘场景,剩下 10% 才真正能跑通。团队层的核心动作是过筛——用三条硬标准(痛点足够真实、场景足够聚焦、数据能拿到)筛出那 10%,跑成生产系统。跑通之后,反复出现的 Prompt 模式、数据源、动作,就是喂给企业层的基建需求信号——Bottom-up 是 Top-down 基建最靠谱的需求发现方式。
这条路径的优势在于速度、痛点真实度、员工参与感、试错成本低。代价在中长期才浮出水面:碎片化、难扩展、技术债累积快、合规隐患。这些都不是路径本身错了,是 Bottom-up 单独跑必然的结局。适合走这条路的企业是互联网、消费品、创意服务、新经济——迭代快、组织扁平、试错文化强的行业。
想看深挖——4 种舞台各自怎么搭、3 条筛选标准如何应用、企业层怎么沉淀跑通的场景、某消费品集团从 200 个 idea 到 5 个上线的完整案例——读 《自下而上的 AI 落地:从员工 idea 到生产的通道》。
Enduring principle: Bottom-up 不是"民主投票",是"场景发现"。让员工提案的目的不是让每个 idea 都上线,是让最真实的痛点浮出水面。
什么时候偏哪一边
不是所有企业都适合"两条路径 50/50"。行业属性决定了稳态比例,企业成熟度决定了三年演进。先看你在哪一格:
| 企业 / 行业属性 | 推荐比例(Top-down : Bottom-up) | 原因 |
|---|---|---|
| 银行 / 保险 / 电力 / 政府 | 70 : 30 | 合规和权限是硬门槛,Bottom-up 的自由度受限 |
| 大型制造 / 能源 | 60 : 40 | IT / OT 集成需求强,但一线知识密度高 |
| 零售 / 消费品 | 40 : 60 | 场景多、迭代快,中台建慢来不及 |
| 互联网 / 新经济 | 30 : 70 | 一线员工 = 产品设计者,Bottom-up 最快 |
| 传统制造转型期 | 50 : 50 | 双轨并行,边打边建 |
这张表要读的不是"我该走哪一格",是"我该给哪一条路径更多资源"。所有企业都需要两条路径,只是配比不同。70:30 不代表 Bottom-up 不做,是在预算和管理注意力上,Top-down 拿大头。
时间轴上还有一个更重要的变化:同一家企业在不同阶段该走的路径完全不同。
| 阶段 | 时间 | 主导路径 | 核心动作 | 最常见的错误 |
|---|---|---|---|---|
| 找场景 | 第 1 年 | Bottom-up | 让员工提案、跑通 3–5 个高价值场景 | 急着立项 AI 中台 |
| 并行沉淀 | 第 2 年 | 并行 | 把跑通的场景抽象成 Registry 与 API | 写 40 页架构文档而不是提炼 5 个真实需求 |
| 规模化 | 第 3 年+ | Top-down | 复用、治理、把 20 个场景放大到 200 | 停止发现新场景,只在存量里打转 |
第 1 年应该偏 Bottom-up:重点是找场景。这时候公司还没跑通任何 AI 场景,任何"我们应该建什么平台"的讨论都是空对空。让员工提案、让团队筛选、让 3–5 个高价值场景先跑起来,是最快的路径。这一年最应该做的事是"制造 20 个小实验",而不是"启动一个大项目"。你在信息不足时做的大项目,几乎肯定是错的。
第 2 年进入并行:一边继续 Bottom-up 找新场景,一边把跑通的场景抽象成企业级能力。这一年是最累的,也是最出成绩的。前 5 个场景的经验足够定义平台方向,后续场景开始享受平台红利。这一年最容易犯的错是"急着建大平台"——因为已经跑通了 5 个场景,团队会有信心去规划"完整的 AI 中台"。但完整的 AI 中台是第 3 年的事。第 2 年应该做的是"把 5 个场景里重复出现的能力先沉淀成 Registry",不是"设计一个 40 页的中台架构文档"。
第 3 年及以后偏 Top-down:这时候平台已经知道要服什么、业务方也知道从平台拿什么。核心工作变成"复用与治理":把散落的 Prompt 归一、把数据接入接口收敛、把权限模型统一到 Ontology 里。这一年应该做的是"扩大规模"——把 20 个场景变成 200 个,把 3 个部门用起来变成 30 个部门用起来。
这条曲线也可以反过来读:如果你今天已经在纠结"要不要立项 AI 中台",多半说明你还在第 1–2 年之间。先把 3–5 个场景跑通再谈平台。基建立得早,未必立得对。
让两条路径互相喂养
单纯走一条路径,早晚会碰到瓶颈。
只走 Top-down 的结局,是建了一年平台、业务方还是不知道用来做什么。因为 IT 猜的场景永远猜不准业务方真正在做的事。基建投入了几千万,最后变成了一个漂亮的 PPT 里的架构图。只走 Bottom-up 的结局同样糟糕:跑了 20 个 Agent,每个都用不同的技术栈、不同的数据接入、不同的评估方式;跨场景零复用,技术债 12 个月内碾压场景收益,最后不得不推倒重来。这两种失败模式我们都在客户现场反复见过。它们不是路径本身的问题,是路径没有对手方的问题。
真正跑得快的企业,是让两条路径互相喂养:Bottom-up 找到的痛点变成 Top-down 的能力清单,Top-down 的基建变成 Bottom-up 的加速器。这个"喂养"是双向的、持续的、有节奏的,不是一次性的对齐。它更像两个齿轮,一个转另一个也在转;停下任何一个,另一个也会慢下来。
                ┌───────────────────────────────────────┐
                │           翻译层 · 齿轮              │
                │   Platform Team / FDE                 │
                │   既懂业务、又能动手改代码             │
                └──────────────┬────────────────────────┘
                               │
             ┌─────────────────┴─────────────────┐
             │                                   │
             ▼                                   ▼
   ┌─────────────────────┐              ┌──────────────────────┐
   │     Bottom-up       │              │      Top-down        │
   │     场景发现         │              │      基建演进          │
   │                     │              │                      │
   │  · Hackathon        │  ─场景反哺→   │  · Prompt Registry   │
   │  · Playground       │              │  · Data-Access API   │
   │  · 提案通道          │  ←加速 MVP─   │  · Ontology / Action │
   └─────────────────────┘              └──────────────────────┘
             ▲                                   ▲
             │        每 3–6 个月对齐一次          │
             └───────────────────────────────────┘
Bottom-up 到 Top-down 的方向是场景反哺基建。员工在客服团队发现"退款审批要跨 3 个系统才能完成",这不是一个孤立的场景需求。它反过来告诉平台团队 Ontology 里的 Action Type 该怎么建、跨系统的动作抽象层该长什么样。同样,供应链团队发现"库存预测要拼 4 个数据源",反哺的是企业级数据接入 API 的设计。每一个跑通的 Bottom-up 场景,都是一份写给平台团队的需求规格说明书:只不过这份说明书不是文档,是活生生跑着的代码。这种"从代码里读需求"的方式,比业务方写的 PRD 精确得多。因为代码不会说谎。
Top-down 到 Bottom-up 的方向是基建加速场景。平台建好统一的评估集工具、灰度回滚工具、Prompt Registry 之后,下一波 Hackathon 的 MVP 上线速度从 6 周降到 2 周,因为员工不再需要自己搭这些底层。基建的每一次进化,都在给下一批场景发力。这个反馈是有滞后的:基建今天进化,收益在 3 个月后才显现。但一旦滞后跨过去,Bottom-up 的产出速度会跳一个数量级。
这不是理论,是我们在客户现场反复看到的规律:头 3 个 Bottom-up 场景,基本定义了未来 2 年 Top-down 平台的核心能力集。而这个反过来的关系同样重要:第 4 个场景之后,Top-down 平台的每一次能力上线,都在让 Bottom-up 的下一波场景更容易起来。
关键机制:一个"翻译层"
两条路径互相喂养的过程不是自然发生的。如果没有一个专门做双向翻译的角色,Bottom-up 的场景清单和 Top-down 的能力清单永远是两张对不上的表。业务方抱怨"平台没有我们要的功能",平台方抱怨"业务方提的需求都不能通用化",两边都对,但两边都动弹不得。这种"两个正确的部门产生一个错误的组织",是所有大型企业 AI 战略里最常见的失败模式。
这个翻译层负责的正是双向传递。从业务方向平台:他们要能看出"这个场景反复出现了,平台该建一个通用能力",把散落的需求收敛成 backlog,而不是照单全收。他们要能识别"这三个团队提的 idea 其实是同一个抽象问题",然后把这个抽象问题喂给平台团队。从平台向业务方:他们要能看出"这个新能力可以让哪些团队直接用起来",主动把能力推给能受益的场景,而不是等业务方自己发现。他们要能翻译"平台上线了一个新的 Retrieval API"变成"这意味着你们客服团队原来跑不通的那个场景,现在可以跑了"——用业务方的语言重新表达技术能力。
这个角色在业界有多种名字:Platform Team、AI Enablement、Forward Deployed Engineer。名字不同,本质相同:一个既懂业务、又能动手改代码的人(或团队),坐在两条路径中间。没有他们,两条路径各自跑,永远汇不到一起。而找到合适的翻译层是所有企业 AI 落地里最难的招聘题:懂业务的人通常不写代码,写代码的人通常不懂业务。所以能同时做到两件事的人极其稀缺,是任何 AI 组织真正的护城河。
Enduring principle: Bottom-up 出场景,Top-down 出能力;FDE / Platform Team 是把两者咬合起来的齿轮。
给企业的四条实操建议
1. 不要先问"怎么建 AI 平台",先问"哪些场景值得建"
先建平台再找场景,几乎没有成功的。平台不是拍脑袋想出来的,是被场景反复要求出来的。先跑通 3–5 个真实场景,再从这些场景反推平台要长什么样。这时候你会发现,真正需要的能力比你原本以为的要少得多,也具体得多。
我们在客户现场经常看到这样的对比:一家企业在第 0 天写下的"AI 中台架构文档",通常有 40 页、覆盖 15 个能力模块。等到跑通了 5 个场景之后,回头再看这份文档,团队自己会指出其中至少一半是当初以为需要、其实用不上的能力。反过来,跑通 5 个场景之后暴露出的真实需求,有一半是当初完全没想到的。你不真的做,就不知道真的需要什么。
2. 不要让 Hackathon 变成年度秀
组织 Hackathon 很热闹,问题是 90% 的 idea 上不了生产。真正有价值的机制不是 Hackathon 本身,是从 idea 到生产的通道:员工的想法怎么被评估、被资源化、被跑通、被沉淀。一个 Hackathon 后面必须挂着一个 6 周 sprint 的资源池、一个明确的"上线负责人"、一套上线后的运营机制。没有这些,Hackathon 每年都在给自己做同一份 PPT。
判断一家公司的 Hackathon 是不是有价值,最简单的方法是问一个问题:"去年 Hackathon 上跑通的 idea,有几个还在生产里跑?"如果答案是 0,那今年办的这场也不会有更好的结果。因为机制没变。
3. 每个 Bottom-up 场景都要跑通"数据 → 逻辑 → 动作"完整链路
一个能"演示 demo"但不能真的读客户数据、不能真的触发审批动作、不能被留痕的 Agent,不算跑通。Demo 上线是零,生产上线才是一。之间的距离,往往是 Bottom-up 项目最容易低估的部分。给团队的验收标准从"能演示"改成"能被业务方每天用",这一改,能让 80% 的"半成品"提前暴露。
Demo 和生产之间隔着的,不是"再多写一点代码",是数据接入的权限、错误处理的完整性、留痕的合规性、灰度和回滚的机制。每一样都是脏活累活,但每一样又都是生产环境的硬门槛。把这道分界线画清楚,是给团队最有价值的礼物:它让每个项目从第一天就知道自己在给"生产上线"投资,而不是给"下季度演示"投资。
4. 用 6 个月做体检
半年后拉两张表,是最快确认两条路径健康度的方式。
| 路径 | 关键指标 | 健康信号 | 异常信号 & 诊断 |
|---|---|---|---|
| Bottom-up | 提案数 → 筛出数 → 上线数 → 3 个月存活数 | 漏斗每一层保留 30–50% | 提案数低 = 员工没被激活;筛出数低 = 无筛选机制;上线数 = 0 → 通道未打通;存活数低 = demo 与生产之间没跨过去 |
| Top-down | 能力数、跨部门调用数、新场景接入天数 | 调用数持续上升,接入天数持续下降 | 能力数多但调用数 = 0 → 基建方向错了,建了业务方不需要的东西 |
Bottom-up 表记录漏斗:员工提了多少 idea、团队筛出了几个、真上线的有几个、上线后 3 个月还在跑的有几个。四个数字从上到下,每一步的转化率都告诉你哪个环节在漏。提案数不够,是员工没被激活。筛选数不够,是团队没有筛选机制。上线数不够,是通道没打通。3 个月存活数不够,是"能演示"和"能用"之间没跨过去。
Top-down 表记录复用:平台建了哪些能力、被跨部门调用了多少次、平均一个新场景接入需要多少天。三个数字揭示的是基建有没有真被用。能力数只是投入的证明,跨部门调用数才是价值的证明,接入天数才是复用效率的证明。
如果 Bottom-up 上线数 = 0,说明通道没打通,Hackathon 白办了。如果 Top-down 跨部门调用数 = 0,说明基建方向错了,建了业务方不需要的东西。这两个数字比任何 KPI 都更能反映一家公司 AI 战略的真实进展:远比"我们上线了 X 个 Agent"更真实,因为它同时衡量了成果和方向。
回到会议室
那场僵局的正确答案,不是选一个方向。是让平台负责人和业务负责人当天下班前坐下,各自拿出一份东西:平台负责人拿出一份 3 个月内要交付的最小能力集(不是 12 个月的路线图),业务负责人拿出3 个员工提案里 ROI 最高的场景(不是"我们要探索一下 AI")。
再让翻译层(Platform Team 或 FDE)把两张纸咬合起来:这 3 个能力能不能撑起这 3 个场景?如果不能,先补哪个能力?这才是"AI 战略"的真实工作现场,不是董事会上的口号,也不是 PPT 里的架构图。它每次的产出都是极其具体的:3 个场景、3 个能力、一个 3 个月的交付时间线。不宏大,但它是唯一能落地的形态。
半年之后你会发现,这 3 个场景变成了 15 个场景,这 3 个能力变成了 12 个能力,翻译层从 1 个人变成了 5 个人的小团队。这就是企业级 AI 战略真正在跑起来的样子。不是一场董事会决议就能完成的,是上百次"基建 ↔ 场景"的对齐慢慢累积出来的。
企业级 AI 战略的真正核心能力,其实就一个:把两条路径的节奏对齐。谁能做到这一点,谁就能在这一轮 AI 落地里跑得最快。
系列文全部三篇:
- 主篇(本文):《企业 AI 落地的两条路径:为什么最好的答案是"同时走"》
- 深挖 · Top-down:《自上而下的 AI 基建:5 个支柱与最贵的失败》
- 深挖 · Bottom-up:《自下而上的 AI 落地:从员工 idea 到生产的通道》